

Цю статтю адаптовано з книги Уейна Л. Вінстона " Аналіз даних і бізнес-моделювання Microsoft Excel ".
Огляд
- Хто використовує симуляцію Монте-Карло?
- Що відбувається, якщо ввести =RAND() у клітинку?
- Як можна змоделювати значення дискретної випадкової величини?
- Як можна змоделювати значення нормальної випадкової величини?
- Як компанія, що випускає вітальні листівки, може визначити, скільки листівок виготовити?
Ми хотіли б точно оцінити ймовірності невизначених подій. Наприклад, яка ймовірність того, що грошові потоки нового продукту матимуть додатну чисту поточну вартість (NPV)? Який фактор ризику нашого інвестиційного портфеля? Моделювання Монте-Карло дозволяє нам моделювати ситуації, які представляють невизначеність, а потім розігрувати їх на комп'ютері тисячі разів.
Примітка.
Назва симуляції Монте-Карло походить від комп'ютерного моделювання, проведеного в 1930-х і 1940-х роках для оцінки ймовірності того, що ланцюгова реакція, необхідна для детонації атомної бомби, буде успішною. Фізики, які брали участь у цій роботі, були великими шанувальниками азартних ігор, тому вони дали симуляціям кодову назву Монте-Карло.
У наступних п'яти розділах ви побачите приклади використання програми Excel для моделювання Монте-Карло.
Хто використовує симуляцію Монте-Карло?
Багато компаній використовують симуляцію Монте-Карло як важливу частину процесу прийняття рішень. Ось кілька прикладів.
- General Motors, Proctor and Gamble, Pfizer, Bristol-Myers Squibb і Eli Lilly використовують моделювання для оцінки як середньої прибутковості, так і фактора ризику нових продуктів. У GM ця інформація використовується генеральним директором для визначення продуктів, які надходять на ринок.
- GM використовує моделювання для таких видів діяльності, як прогнозування чистого прибутку корпорації, прогнозування структурних і закупівельних витрат, а також визначення її схильності до різних видів ризику (таких як зміна процентних ставок і коливання обмінного курсу).
- Lilly використовує моделювання для визначення оптимальної потужності рослини для кожного препарату.
- Proctor and Gamble використовує моделювання для моделювання та оптимального хеджування валютного ризику.
- Компанія Sears використовує моделювання, щоб визначити, скільки одиниць кожної лінійки продукції слід замовляти у постачальників, наприклад, кількість пар штанів Dockers, які слід замовити цього року.
- Нафтові та фармацевтичні компанії використовують симуляцію для оцінки «реальних варіантів», таких як вартість опціону на розширення, укладання контракту або відстрочку проекту.
- Фахівці з фінансового планування використовують моделювання Монте-Карло для визначення оптимальних інвестиційних стратегій для виходу своїх клієнтів на пенсію.
Що відбувається, якщо ввести =RAND() у клітинку?
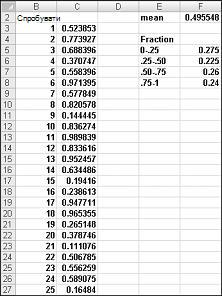
Якщо ввести в клітинку формулу =RAND(), ви отримаєте число, яке з однаковою ймовірністю прийме будь-яке значення від 0 до 1. Таким чином, приблизно в 25 відсотках випадків ви повинні отримати число, менше або рівне 0,25; Приблизно в 10 відсотках випадків ви повинні отримати число не менше 0,90 і так далі. Щоб продемонструвати, як працює функція RAND, погляньте на Randdemo.xlsx файлу, зображену на малюнку 60-1.
Примітка.
При відкритті файлу Randdemo.xlsx ви не побачите тих самих випадкових чисел, показаних на малюнку 60-1. Функція RAND завжди автоматично переобчислює числа, згенеровані під час відкриття аркуша або введення на нього нових відомостей.
Спочатку скопіюйте із клітинки C3 до клітинки C4:C402 формулу =RAND(). Потім вам буде присвоєно ім'я діапазону C3:C402 "Дані". Потім у стовпці F можна відстежувати середнє з 400 випадкових чисел (клітинка F2) і за допомогою функції COUNTIF визначити дроби між 0 і 0,25, 0,25 і 0,50, 0,50 і 0,75 та 0,75 і 1. Якщо натиснути клавішу F9, випадкові числа переобчисляться. Зверніть увагу, що середнє з 400 чисел завжди дорівнює приблизно 0,5, а 25 відсотків результатів – з інтервалом 0,25. Ці результати узгоджуються з визначенням випадкового числа. Зверніть увагу, що значення, згенеровані функцією RAND у різних клітинках, є незалежними. Наприклад, якщо випадкове число, створене у клітинці C3, – велике число (наприклад, 0,99), воно нічого не говорить про значення інших згенерованих випадкових чисел.
Як можна змоделювати значення дискретної випадкової величини?
Припустімо, що попит на календар визначається такою дискретною випадковою змінною:
| Попит | імовірність |
|---|---|
| 10 000 | 0,10 |
| 20 000 | 0.35 |
| 40,000 | 0,3 |
| 60 000 | 0,25 |
Як можна змусити Excel багато разів відтворити або імітувати цю вимогу до календарів? Хитрість полягає в тому, щоб пов'язати кожне можливе значення функції RAND із можливим попитом на календарі. Наведене нижче призначення гарантує, що потреба в 10 000 виконуватиметься в 10 відсотках випадків і так далі.
| Попит | Випадкове число призначено |
|---|---|
| 10 000 | Менше 0,10 |
| 20 000 | Більше або дорівнює 0,10 та менше 0,45 |
| 40,000 | Більше або дорівнює 0,45 та менше 0,75 |
| 60 000 | Більше або дорівнює 0,75 |
Щоб продемонструвати моделювання попиту, подивіться на файл Discretesim.xlsx, показаний на малюнку 60-2 на наступній сторінці.
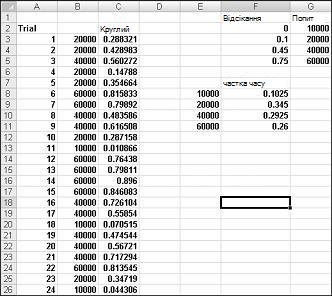 Ключ до симуляції полягає в тому, щоб за допомогою випадкового числа ініціювати підстановку з діапазону таблиці F2:G5 (який називається підстановкою). Випадкові числа, більші або рівні 0 і менші 0,10, дадуть потребу 10 000; випадкові числа, більші або рівні 0,10 і менше 0,45, дадуть потребу 20 000; випадкові числа, більші або рівні 0,45 і менші 0,75, дадуть потребу в 40 000; а випадкові числа, більші або рівні 0,75, дадуть потребу 60 000. Щоб згенерувати 400 випадкових чисел, потрібно скопіювати з клітинки C3 до клітинки C4:C402 формулу RAND(). Потім можна створити 400 випробувань або ітерацій календарного попиту, скопіювавши з B3 до B4:B402 формулу VLOOKUP(C3;lookup;2). Ця формула гарантує, що будь-яке випадкове число, менше 0,10, породжує потребу 10 000, будь-яке випадкове число між 0,10 і 0,45 породжує потребу 20 000 і т. д. У діапазоні клітинок F8:F11 скористайтеся функцією COUNTIF, щоб визначити частку від 400 ітерацій, які приносять кожному попиту. Коли ми натискаємо клавішу F9 для повторного обчислення випадкових чисел, змодельовані ймовірності стають близькими до передбачуваних імовірностей попиту.
Як можна змоделювати значення нормальної випадкової величини?
Якщо ввести в будь-яку клітинку формулу NORMINV(rand();mu;sigma), буде згенеровано симульоване значення нормальної випадкової величини із середнім mu та сигмою стандартного відхилення. Ця процедура проілюстрована на Normalsim.xlsx файлу, показаному на малюнку 60-3.
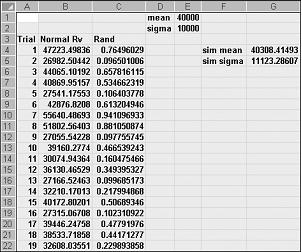 Припустімо, потрібно змоделювати 400 випробувань, або ітерацій, для нормальної випадкової величини із середнім значенням 40 000 і стандартним відхиленням 10 000. (Можна ввести ці значення в клітинки E1 і E2 й відповідно назвати відповідні назви "середнє " та "сигма"). Якщо скопіювати формулу =RAND() із клітинки C4 до C5:C403, згенерується 400 різних випадкових чисел. Під час копіювання з клітинки B4 до клітинки B5:B403 формула NORMINV(C4;середнє;сигма) повертає 400 різних значень випробувань із нормальної випадкової величини із середнім значенням 40 000 і стандартним відхиленням 10 000. Коли ми натискаємо клавішу F9 для переобчислення випадкових чисел, середнє значення залишається близьким до 40 000, а стандартне відхилення близьке до 10 000.
По суті, для випадкового числа х формула NORMINV(p,mu,sigma) генерує p-йпроцентиль нормальної випадкової величини із середнім mu і сигмою стандартного відхилення. Наприклад, випадкове число 0,77 у клітинці C4 (див. Рис. 60-3) генерує у клітинці B4 приблизно 77-й процентиль нормальної випадкової величини із середнім значенням 40 000 і стандартним відхиленням 10 000.
Як компанія, що випускає вітальні листівки, може визначити, скільки листівок виготовити?
У цьому розділі ви побачите, як симуляція Монте-Карло може бути використана як інструмент прийняття рішень. Припустімо, попит на листівку до Дня святого Валентина регулюється такою випадковою дискретною змінною:
| Попит | імовірність |
|---|---|
| 10 000 | 0,10 |
| 20 000 | 0.35 |
| 40,000 | 0,3 |
| 60 000 | 0,25 |
Вітальна листівка продається за 4,00 долара, а змінні витрати на виготовлення кожної листівки становлять 1,50 долара. Картки, що залишилися, необхідно утилізувати за ціною 0,20 долара США за картку. Скільки карток потрібно надрукувати?
По суті, ми моделюємо кожну можливу кількість продукції (10 000, 20 000, 40 000 або 60 000) багато разів (наприклад, 1000 ітерацій). Потім визначаємо, яка кількість замовлення дає максимальний середній прибуток за 1000 ітерацій. Дані для цього розділу можна знайти у файлі Valentine.xlsx, наведеному на рисунку 60-4. Імена діапазонів у клітинках B1:B11 призначаються клітинкам C1:C11. Для діапазону клітинок G3:H6 призначено підстановку імені. Наші параметри збутової ціни та витрат заносяться в клітинки C4:C6.
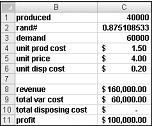 profit У клітинку C1 можна ввести опробну кількість продукції (40 000 у цьому прикладі). Потім створіть випадкове число у клітинці C2 за допомогою формули =RAND(). Як описано вище, моделюється попит на картку в клітинці C3 за допомогою формули VLOOKUP(rand;lookup;2). (У формулі VLOOKUP rand – це ім'я клітинки, призначене клітинці C3, а не функція RAND.)
Кількість проданих одиниць товару менша від обсягу виробництва та попиту. У клітинці C8 ваш дохід обчислюється за формулою MIN(вироблено;попит)*unit_price. У клітинці C9 ви обчислюєте загальну виробничу вартість за формулою* unit_prod_cost.
Якщо ми виробляємо більше карт, ніж користується попитом, то кількість одиниць, що залишилися, дорівнює виробництву мінус попит; в іншому випадку не залишиться жодного юніту. Вартість утилізації обчислюється у клітинці C10 за формулою unit_disp_cost*IF(вироблений>попит;вироблено–попит;0). Нарешті, у клітинці C11 ми обчислюємо прибуток як дохід – total_var_cost-total_disposing_cost.
Нам потрібен ефективний спосіб натиснути F9 багато разів (наприклад, 1000) для кожної виробничої кількості та підрахувати наш очікуваний прибуток для кожної кількості. У цій ситуації нам на допомогу приходить двостороння таблиця даних. (Докладніше про таблиці даних див. у розділі 15. Розділ 15.) Таблиця даних, використана в цьому прикладі, наведена на рисунку 60-5.
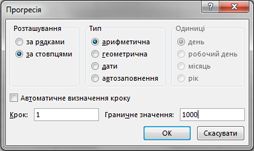
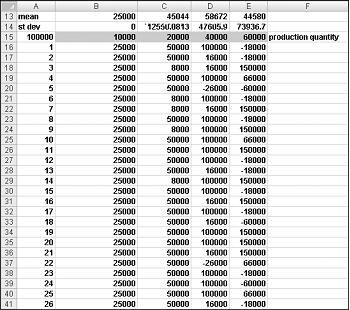 У діапазоні клітинок A16–A1015 введіть числа від 1 до 1000 (що відповідає 1000 випробувань). Один із простих способів створення таких значень – ввести 1 у клітинку A16. Виділіть клітинку, а потім на вкладці "Основне" у групі "Редагування" натисніть кнопку "Заливка" та виберіть значення "Ряд", щоб відобразити діалогове вікно "Ряд". У діалоговому вікні «Ряд», показаному на малюнку 60-6, введіть значення кроку 1 і значення стопа 1000. В області "Ряд" виберіть параметр "Стовпці" та натисніть кнопку "OK". Числа від 1 до 1000 буде введено у стовпець A, починаючи із клітинки A16.
 Далі введіть можливі обсяги виробництва (10 000, 20 000, 40 000, 60 000) у клітинки B15:E15. Потрібно обчислити прибуток для кожного номера випробування (від 1 до 1000) і кожної виробничої кількості. Ми посилаємося на формулу для прибутку (обчислювана в клітинці C11) у верхній лівій клітинці таблиці даних (A15), ввівши =C11.
Тепер ми готові обдурити Excel, змусивши його змоделювати 1000 ітерацій попиту для кожної кількості продукції. Виберіть діапазон таблиці (A15:E1014), а потім на вкладці "Дані" у групі "Знаряддя даних" натисніть кнопку "Аналіз "Що якщо" та виберіть "Таблиця даних". Щоб настроїти двосторонню таблицю даних, виберіть кількість продукції (клітинка C1) як клітинку введення рядків і будь-яку пусту клітинку (ми вибрали клітинку I14) як клітинку введення стовпця. Після натискання кнопки OK Excel імітує 1000 значень попиту для кожної кількості замовлення.
Щоб зрозуміти, чому це працює, розглянемо значення, розміщені в таблиці даних у діапазоні клітинок C16:C1015. Для кожної з цих клітинок Excel використовуватиме значення 20 000 у клітинці C1. У клітинці C16 значення клітинки введення 1 у стовпці поміщається в пусту клітинку, а випадкове число у клітинці C2 переобчислюється. Відповідний прибуток записується у клітинку C16. Після цього введене значення 2 у клітинці стовпця буде розміщено в пустій клітинці, а випадкове число у клітинці C2 знову переобчислюється. Відповідний прибуток заноситься до клітинки C17.
Скопіювавши формулу AVERAGE(B16:B1015) із клітинки B13 до клітинки C13:E13, можна обчислити середнє зімітування прибутку для кожної кількості продукції. Скопіювавши формулу STDEV(B16:B1015) із клітинки B14 до клітинки C14:E14, ми обчислимо стандартне відхилення модельованого прибутку для кожної кількості замовлення. Щоразу, коли ми натискаємо клавішу F9, для кожної кількості замовлення моделюється 1000 ітерацій попиту. Випуск 40 000 карток завжди приносить найбільший очікуваний прибуток. Тому виходить, що виготовити 40 000 карток – це правильне рішення.
Вплив ризику на наше рішення Якщо ми випустили 20 000 замість 40 000 карт, наш очікуваний прибуток впаде приблизно на 22 відсотки, але наш ризик (виміряний стандартним відхиленням прибутку) знизиться майже на 73 відсотки. Тому, якщо ми вкрай не схильні ризикувати, виготовити 20 000 карток може бути правильним рішенням. До речі, виробництво 10 000 карток завжди має стандартне відхилення в 0 карт, тому що якщо ми випустимо 10 000 карток, ми завжди продамо їх усі без будь-яких залишків.
Примітка.
У цій книзі для параметра "Обчислення " вибрано значення "Автоматично", крім таблиць. (Скористайтеся командою "Обчислення" в групі "Обчислення" на вкладці "Формули".) Завдяки цьому параметру таблиця даних не переобчислюватиметься, якщо не натиснути клавішу F9 (це гарна ідея), адже велика таблиця даних сповільнюватиме роботу під час кожного повторного обчислення даних під час кожного введення даних на аркуші. Зверніть увагу, що в цьому прикладі щоразу, коли ви натискаєте клавішу F9, середній прибуток змінюватиметься. Це відбувається тому, що кожного разу, коли ви натискаєте клавішу F9, використовується інша послідовність із 1000 випадкових чисел, щоб сформувати попит на кількість кожного замовлення.
Довірчий інтервал для середнього прибутку У цій ситуації виникає закономірне запитання: через який проміжок часу ми на 95 відсотків впевнені, що впаде справжній середній прибуток? Цей інтервал називається 95-відсотковим довірчим інтервалом для середнього прибутку. 95-відсотковий довірчий інтервал для середнього значення будь-якого результату моделювання обчислюється за такою формулою:
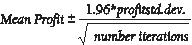
У клітинці J11 обчислюється нижня межа для 95-відсоткового довірчого інтервалу для середнього прибутку, якщо створено 40 000 календарів, за формулою D13–1,96*D14/SQRT(1000). У клітинці J12 обчислюється верхня межа для 95-відсоткового довірчого інтервалу за формулою D13+1,96*D14/SQRT(1000). Ці розрахунки показані на малюнку 60-7.
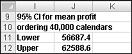 Ми на 95 відсотків впевнені, що наш середній прибуток при замовленні 40 000 календарів становить від 56 687 до 62 589 доларів.
Проблеми
Дилер GMC вважає, що попит на Envoys 2005 року зазвичай розподіляється із середнім значенням 200 і стандартним відхиленням 30. Його вартість отримання посланника становить 25 000 доларів, а посланця він продає за 40 000 доларів. Половина всіх «Посланців», не проданих за повною ціною, може бути продана за 30 000 доларів. Він розглядає можливість замовлення 200, 220, 240, 260, 280 або 300 посланців. Скільки він повинен замовити?
Невеликий супермаркет намагається визначити People, скільки примірників журналу вони повинні замовляти щотижня. Вони вважають, що їх попит на People регулюється наступною дискретною випадковою змінною:
Попит імовірність 15 0,10 20 0.20 25 0.30 30 0,25 35 0,15 Супермаркет платить 1,00 долара за кожну копію People і продає її за 1,95 долара. Кожен непроданий примірник можна повернути за $0,50. Скільки копій People має замовити магазин?
Потрібна додаткова довідка?
Ви завжди можете поставити запитання експерту в спільноті Tech у Excel або отримати підтримку в спільнотах.